Setiap server, jaringan, dan izin di balik AdZoic ditulis sebagai kode. Kami harus menumbuhkan platform itu tanpa anggaran besar, dan saat membaca ulang riwayat perubahannya, satu pola terus muncul: sebagian besar perbaikan terbaik kami berupa pengukuran, bukan pembelian. Beginilah wujudnya dalam praktik — keputusan-keputusannya, harga di baliknya, dan satu titik ketika kode dan kenyataan diam-diam tidak lagi sejalan.
Mengapa seluruh platform ditulis sebagai kode
“Infrastructure as code” berarti kami tidak membangun server dengan mengeklik-klik di sebuah konsol. Kami menuliskan apa yang seharusnya ada — mesin, jaringan, database, aturan tentang siapa boleh mengakses apa — dalam file teks biasa, menggunakan alat bernama Terraform. Alat itu kemudian menyesuaikan dunia nyata agar cocok dengan file-file tersebut.
Tiga hal mengikutinya, dan ketiganya menghemat uang:
- Tidak ada yang berjalan terlupakan. Jika sesuatu ada, pasti tertulis, sehingga tak ada yang menemukan mesin di tagihan yang tidak diingat siapa pun pernah dinyalakan.
- Setiap perubahan ditinjau sebelum terjadi, seperti perubahan kode lainnya, alih-alih baru ketahuan belakangan.
- Sebuah environment bisa dibangun ulang dari nol. Environment pengujian yang tidak dibutuhkan bisa dimatikan dan dihidupkan kembali nanti persis seperti semula.
Artikel arsitektur membahas apa yang dilakukan platform ini. Artikel ini membahas cara kami menjaganya tetap ramping.
Satu definisi, setiap environment
Kami menjalankan environment pengujian dan produksi secara terpisah, dan fondasi yang sama melayani lebih dari satu produk. Pada awalnya, setiap environment punya salinan lengkap definisi infrastrukturnya sendiri: masing-masing satu file panjang, ratusan baris.
Salinan itu mahal dengan cara yang tidak pernah muncul di faktur. Setiap perbaikan harus dilakukan beberapa kali, dan mudah sekali memperbaikinya di dua tempat lalu melewatkan yang ketiga. Lama-kelamaan salinan-salinan itu diam-diam tidak lagi sama, dan “konfigurasi yang sama” berarti sesuatu yang sedikit berbeda di setiap tempat.
Karena itu kami mengubah seluruh platform menjadi satu modul — satu definisi untuk stack lengkap. Setiap environment kini berupa file pendek yang hanya menyebutkan apa yang berbeda darinya: namanya, seberapa besar ukurannya, dan bagian mana yang diaktifkan. Sebuah perbaikan dilakukan sekali dan sampai ke setiap environment. Environment baru cukup berupa file pendek baru, bukan salinan baru dari semuanya.
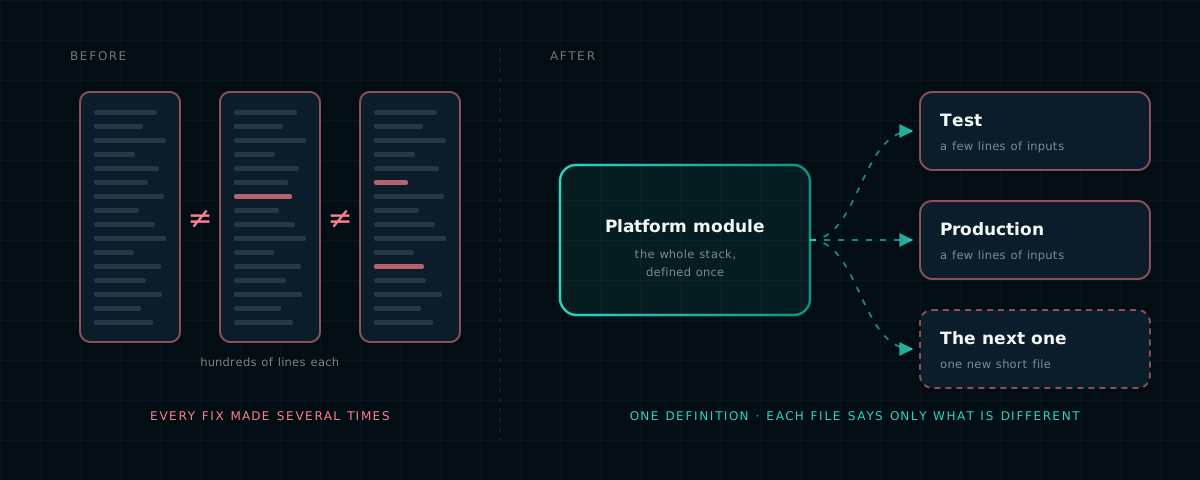
Sebelumnya, setiap environment membawa salinannya sendiri. Sesudahnya, hanya ada satu definisi, dan file setiap environment hanya menyebutkan apa yang membuatnya berbeda.
Hal ini juga mengubah cara environment baru dinyalakan. Setiap bagian utama — jaringan, cluster, pintu depan, monitoring, database, pipeline data — punya sakelarnya sendiri. Kami menyalakannya satu per satu dan memeriksa masing-masing sebelum lanjut ke berikutnya. Saat ada yang gagal, Anda tahu bagian mana penyebabnya.
Daftar harga adalah bagian dari desain
Harga cloud itu rinci dan terbuka untuk publik, artinya sebagian besar biaya sudah ditentukan saat Anda memilih desain, jauh sebelum trafik datang. Berikut pilihan-pilihan yang ditentukan oleh daftar harga. Setiap angka mengacu pada harga on-demand yang dipublikasikan AWS untuk region Singapura, tempat kami beroperasi.
Prosesor ARM, karena perangkat lunaknya tidak keberatan
AWS menjual dua keluarga besar mesin serbaguna: yang dibangun di atas chip x86, seperti kebanyakan laptop, dan yang dibangun di atas chip ARM buatannya sendiri, bernama Graviton. Untuk ukuran mesin yang sama, mesin ARM lebih murah:
Perbandingan harga daftar on-demand untuk mesin x86 dan ARM sebanding dengan ukuran yang sama, Linux, region AWS Asia Pacific (Singapore), per pengecekan 19 September 2026. Ditampilkan sebagai proporsi, bukan harga.
Layanan kami dibangun untuk ARM, sehingga setiap mesin di cluster produksi kami adalah mesin ARM. Ini keputusan paling tidak menarik di artikel ini, dan berlaku untuk setiap jam dari setiap mesin yang kami jalankan.
Environment pengujian tidak mendapat “pipa” kelas produksi
Mesin di jaringan privat butuh jalan keluar ke internet — misalnya untuk mengunduh pembaruan — tanpa internet bisa masuk ke dalam. Di AWS, itu biasanya berupa NAT gateway, dan tagihannya berjalan sejak ia dibuat: puluhan dolar per bulan bahkan sebelum satu byte pun melewatinya, ditambah biaya untuk setiap gigabyte yang ditanganinya.
Produksi memilikinya. Environment pengujian kami dibangun dengan tata letak jaringan yang lebih sederhana yang tidak membutuhkannya, dan satu pengaturan beralih di antara keduanya. Membayar harga produksi untuk environment yang menganggur sepanjang malam berarti membuang uang untuk hal yang sia-sia.
Trafik penyimpanan lewat jalan gratis
Di produksi, semua trafik keluar dulu melewati NAT gateway itu — termasuk trafik ke S3, layanan penyimpanan file AWS. Di sanalah log dan backup kami disimpan, dan dari sanalah lapisan image perangkat lunak yang diunduh setiap mesin berasal. Setiap gigabyte itu dikenai biaya penanganan.
AWS menawarkan rute kedua tepat untuk kasus ini: gateway endpoint, jalan pintas privat dari jaringan kami sendiri ke S3. Tidak ada biaya per jam dan tidak ada biaya per gigabyte. Trafik S3 kini lewat jalan pintas itu, dan selebihnya tetap memakai NAT gateway seperti sebelumnya. Kami menjelaskan bagaimana, mengapa, dan kapan kami beralih di artikel terpisah, beserta pemeriksaan yang layak dilakukan lebih dulu.
Yang satu ini menghemat beberapa dolar per bulan pada volume kami, bukan jumlah yang besar — dan tidak menghapus biaya per jam NAT gateway, karena trafik lain masih membutuhkannya. Alasan yang lebih baik untuk melakukannya adalah ketahanan: backup dan pengiriman log kami tidak lagi bergantung pada sehatnya NAT gateway. Kami tetap menyebutkan penghematan kecil itu. Tulisan yang hanya melaporkan kemenangan besar sebenarnya bukan laporan.
Tertinggal versi ada harganya
AWS menjalankan “otak” cluster Kubernetes kami — bagian yang memutuskan di mana setiap perangkat lunak berjalan. Pada versi Kubernetes yang masih didukung, AWS mengenakan biaya per jam yang wajar untuknya. Biarkan versinya keluar dari dukungan standar, maka AWS menambahkan biaya dukungan diperpanjang (extended support) — total sekitar enam kali lipat harganya, untuk hal yang persis sama.
Perbandingan harga cluster Amazon EKS, dukungan standar versus dukungan diperpanjang, region AWS Asia Pacific (Singapore), per pengecekan 19 September 2026. Ditampilkan sebagai kelipatan, bukan harga.
Hal itu mengubah upaya selalu memperbarui versi dari sekadar tugas rutin menjadi keputusan biaya. Karena upgrade ditulis sebagai kode, upgrade menjadi perubahan rutin, bukan proyek — dan itulah yang mencegahnya terus ditunda.
Setiap resource membawa label
Semua yang dibuat oleh kode otomatis diberi label berisi produknya, environment-nya, dan keterangan bahwa ia dikelola oleh kode. Kedengarannya seperti pembukuan, dan memang begitu. Itu juga yang membedakan “tagihan AWS naik” dengan “penyimpanan environment pengujian naik”. Anda tidak bisa membuat sesuatu lebih murah jika tidak bisa melihat berapa biayanya.
Sebagian besar perbaikan kami berupa pengukuran, bukan pembelian
Inilah pola yang menonjol saat membaca ulang riwayatnya. Ketika sesuatu kekurangan kapasitas, langkah yang terlihat jelas adalah membeli lebih banyak. Namun lebih sering daripada tidak, ketika kami mengukur lebih dulu, kapasitasnya ternyata sudah ada — hanya saja ada sesuatu yang memakainya dengan buruk.
Tiga salinan setiap pesan, tanpa mesin baru
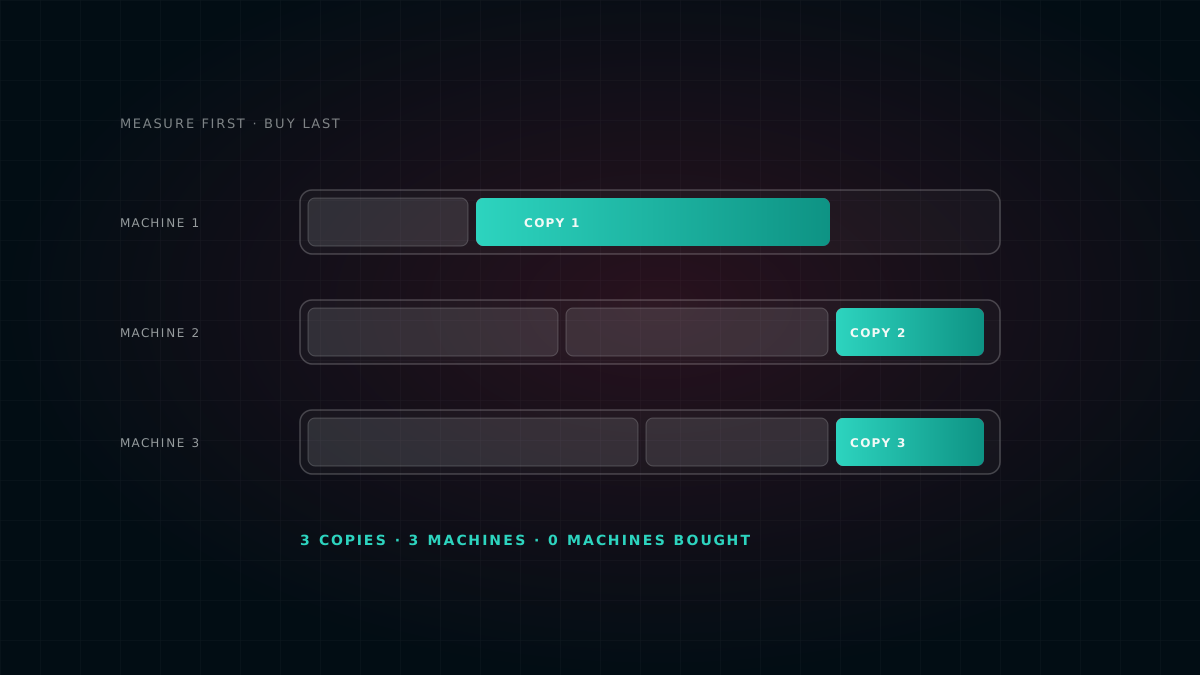
Event stream kami — Redpanda, pipeline yang membawa event lelang dari bidder ke sistem analitik kami — awalnya berjalan di satu server, menyimpan satu salinan setiap pesan. Itu cara yang wajar untuk memulai dari kecil. Namun itu juga merupakan single point of failure, sehingga tujuannya adalah tiga server, masing-masing menyimpan satu salinan.
Percobaan pertama gagal karena kekurangan ruang: tidak ada mesin yang punya kapasitas cadangan cukup untuk server tambahan. Kesimpulan yang tampak jelas adalah kami perlu membeli lebih banyak mesin.
Lalu kami mengukur. Setiap server memesan porsi waktu prosesor yang besar dan tetap untuk dirinya sendiri — pengaturan bawaan — padahal bahkan di saat tersibuknya ia hanya memakai sebagian kecil dari itu. Mesin-mesin “penuh” oleh pemesanan yang tidak dipakai apa pun. Dengan memesan jumlah yang wajar, tetap dengan ruang cadangan yang lega di atas saat tersibuknya, cukup ruang terbebas sehingga tiga server muat di mesin yang sudah kami miliki.
Kini setiap pesan disimpan di tiga server, pada tiga mesin terpisah. Jumlah mesin yang kami beli untuk mencapainya: nol.
Buat opsi yang tidak aman jadi mustahil
Setelah setiap pesan punya tiga salinan, tersisa satu langkah lagi. Stream masih akan menerima permintaan untuk membuat kanal baru — sebuah topic — dengan satu salinan saja, jika ada yang memintanya. Tidak ada yang berniat begitu. Tetapi “tidak ada yang berniat begitu” persis cara single point of failure kembali muncul.
Karena itu batas minimumnya kini ditegakkan oleh sistem itu sendiri: sistem menolak membuat apa pun dengan kurang dari tiga salinan. Aturan yang harus diingat orang adalah aturan yang pada akhirnya akan terlupakan. Aturan yang ditegakkan sistem tidak perlu diingat.
Batching, bukan prosesor yang lebih besar
Database analitik kami, ClickHouse, tampak kekurangan daya pemrosesan: ia rutin tertahan di batasnya. Perbaikan yang tampak jelas adalah menaikkan batas itu.
Ketika kami melihat apa yang sebenarnya dikerjakannya, pekerjaannya adalah beres-beres, bukan menjawab kueri. Database jenis ini menulis setiap batch baris yang masuk sebagai file kecil, lalu terus menggabungkan file-file kecil menjadi file yang lebih besar di latar belakang. Layanan kami hanya mengirim beberapa lusin baris sekaligus — sehingga setiap baris akhirnya ditulis ulang ratusan kali saat file digabung dan digabung lagi. Penulisan kecil-kecil tidak hanya menambah sedikit biaya. Ia memicu badai pekerjaan beres-beres.
Jadi, alih-alih membeli lebih banyak waktu prosesor, kami mengubah cara data masuk: database kini mengumpulkan baris yang masuk selama sesaat lalu menuliskannya bersama-sama. Setiap penulisan tetap menunggu sampai data tersimpan dengan aman sebelum dikonfirmasi — ini batching, bukan “kirim lalu berharap”. Satu-satunya yang dirasakan layanan kami adalah jeda yang sangat singkat, pada penulisan yang memang sudah berjalan di latar belakang.
Kadang jawabannya memang lebih banyak mesin
Mengukur lebih dulu tidak berarti tidak pernah membeli. Seiring trafik tumbuh, ada kalanya cluster benar-benar membutuhkan lebih banyak mesin, dan kami menaikkan batas atas jumlah mesin yang boleh ditambahkan. Bedanya, mesin tambahan datang otomatis ketika ada pekerjaan untuknya dan pergi ketika tidak ada. Kami membayar untuk trafik yang kami dapat, bukan trafik yang mungkin kami dapat suatu hari nanti.
Sebelum membeli kapasitas, cari tahu apa yang sedang dikerjakan kapasitas yang sudah Anda miliki. Dalam riwayat kami, jawabannya biasanya “sesuatu yang tidak perlu” — memesan jauh lebih banyak daripada yang dipakai, atau mengerjakan hal yang sama ratusan kali. Mengukur lebih murah daripada perangkat keras, dan memberi tahu Anda apakah perangkat keras memang akan membantu.
Jaga agar kode tetap jujur
Infrastructure as code hanya berhasil jika kode menggambarkan apa yang benar-benar berjalan. Celah di antara keduanya punya nama — drift — dan ia lebih senyap serta lebih berbahaya daripada kedengarannya.
Saat sebuah perbaikan, memori database analitik kami dinaikkan langsung di sistem yang sedang berjalan dan tidak pernah dituliskan kembali ke kode. Jadi kode menyebut satu jumlah, sementara database sebenarnya berjalan dengan memori lebih besar. Tidak ada yang menyadarinya, karena tidak ada yang tampak salah.
Inilah mengapa hal itu penting. Pembaruan rutin berikutnya — dilakukan untuk alasan yang sama sekali tidak berkaitan — akan “mengoreksi” sistem yang berjalan agar cocok dengan kode. Itu akan memangkas memori database di bawah yang sebenarnya dipakai, dan membuatnya crash. Perubahan yang dimaksudkan tidak berbahaya akan menyebabkan gangguan layanan, dan tidak ada yang akan terpikir untuk memeriksa database lebih dulu.
Kami menemukannya sebelum hal itu terjadi dan menuliskan nilai sebenarnya kembali ke kode. Aturan yang kami ambil darinya: ketika kode dan sistem yang berjalan tidak sejalan, perbedaan itu adalah bug. Perbaiki salah satunya, dengan sengaja. Jangan pernah membiarkan keduanya tidak sejalan.
Artikel arsitektur kami dulu menyebutkan bahwa, karena semuanya ada di Terraform, “tidak ada yang mengalami drift secara diam-diam”. Ini adalah kasus ketika hal itu terjadi. Klaim itu terlalu kuat, dan kami telah mengubah halaman tersebut agar menyatakan yang sebenarnya: drift bisa terjadi, dan ketika terjadi kami memperlakukannya sebagai bug. Menulis artikel tentang menjaga klaim tetap jujur sambil membiarkan kalimat itu tetap ada adalah hal yang keliru.
Sebuah perubahan seharusnya hanya melakukan apa yang dinyatakannya
Dua perbaikan yang lebih kecil memberi pelajaran yang sama:
- Kunci versi hal yang tidak Anda kendalikan. Server kami dimulai dari base image yang dipublikasikan dan diperbarui AWS. Jika dibiarkan “selalu pakai yang terbaru”, perubahan apa pun yang kami buat — misalnya pada monitoring — juga akan memindahkan setiap server ke image terbaru AWS, entah kami menginginkannya hari itu atau tidak. Hal itu pernah terjadi pada kami, dan begitulah kami mengetahuinya. Versi image kini dikunci di kode, dan meng-upgrade-nya menjadi perubahan tersendiri yang disengaja.
- Jangan bergantung pada kondisi baik pihak lain untuk melakukan perubahan Anda sendiri. Satu komponen diunduh dari GitHub setiap kali kami menerapkan pembaruan, sehingga ketika GitHub sedang lambat, perubahan yang sama sekali tidak berkaitan ikut gagal. Kini kami menyimpan salinan komponen itu di repositori kami sendiri.
Prinsipnya sama di keduanya: perubahan pada monitoring seharusnya hanya mengubah monitoring, tidak ada yang lain.
Backup hanya yang tidak punya salinan lain
Backup adalah asuransi, dan asuransi ada preminya. Snapshot disk di AWS kurang lebih ditagih berdasarkan seberapa banyak data yang berubah sejak snapshot terakhir, sehingga biayanya sangat bergantung pada apa yang Anda snapshot — dan sebagian data berubah jauh lebih banyak daripada kelihatannya. Database yang terus-menerus menata ulang file-nya, seperti yang dibahas di atas, membuat snapshot harian jadi mahal, jauh melampaui jumlah data baru yang sebenarnya disimpannya.
Jadi, sebelum mem-backup sesuatu, kami mengajukan satu pertanyaan: apakah ia sudah punya salinan lain?
- Cache yang bisa dibangun ulang dari database utama, dan toh sudah disimpan terpisah setiap malam, tidak memerlukan snapshot disk juga.
- Event stream sudah menyimpan tiga salinan di tiga mesin, sehingga kehilangan satu tetap bisa diatasi tanpa restore.
- Data monitoring dihasilkan ulang oleh sistem yang berjalan, dan dasbornya sendiri ditulis sebagai kode, sehingga bisa dibuat ulang alih-alih dipulihkan.
Langkah itu kira-kira memangkas separuh data yang kami backup. Setiap hal yang tidak kami sertakan punya alasan spesifik, tertulis di samping pengaturannya — bukan karena tampak tidak penting. Hal yang sama berlaku untuk kompromi yang kami pilih untuk diterima: alasannya, termasuk argumen yang menentangnya, dicatat di tempat yang akan dilihat orang berikutnya, sehingga sebuah keputusan bisa ditinjau ulang alih-alih ditemukan ulang.
Tuas yang belum kami tarik
Dua cara terkenal untuk memangkas tagihan AWS sengaja masih kami simpan:
- Mesin dari kapasitas cadangan. AWS menjual kapasitasnya yang tidak terpakai dengan diskon besar, dengan syarat AWS bisa mengambil kembali mesinnya dalam waktu singkat. Itu cocok untuk pekerjaan yang bisa diinterupsi. Untuk apa pun yang menyimpan data, ini butuh kehati-hatian ekstra, jadi ini keputusan untuk workload tertentu, bukan sakelar yang dinyalakan di mana-mana.
- Berkomitmen di muka. AWS memberi diskon untuk mesin yang Anda janjikan akan dipakai selama setahun atau lebih. Itu baru menghemat uang setelah Anda tahu baseline yang stabil, dan baseline kami masih bergerak seiring pertumbuhan trafik. Berkomitmen terlalu dini sama saja membayar mesin yang mungkin tidak Anda butuhkan.
Yang kami petik
- Ukur sebelum membeli. Kapasitas yang Anda butuhkan sering kali sudah ada, sibuk mengerjakan sesuatu yang tidak perlu.
- Baca daftar harga sebagai masukan desain. Banyak biaya ditentukan saat Anda memilih desain, bukan saat trafik datang.
- Buat opsi yang tidak aman jadi mustahil, bukan sekadar kecil kemungkinannya.
- Perlakukan drift sebagai bug. Kode yang tidak menggambarkan apa yang berjalan lebih buruk daripada tidak ada kode, karena ia tampak bisa dipercaya.
- Sebuah perubahan seharusnya hanya melakukan apa yang dinyatakannya. Kunci versi hal yang tidak Anda kendalikan, dan simpan salinan sendiri dari apa yang Anda andalkan.
- Ukur penghematan dengan jujur. Sebagian dari langkah ini menghemat banyak dan satu hanya menghemat beberapa dolar. Keduanya layak dicatat, sesuai ukuran sebenarnya.
Untuk melihat bagaimana semua bagian saling terhubung, baca artikel arsitektur. Untuk kebiasaan serupa — memeriksa apa yang sebenarnya diukur sebuah angka sebelum memercayainya — baca cara kami menguji beban bidder.
Kami sengaja menjelaskan harga dan pengukuran dalam istilah relatif yang dibulatkan, tanpa angka persis. Perbandingan harga mengacu pada harga daftar on-demand yang dipublikasikan AWS untuk Linux di region Asia Pacific (Singapore), per pengecekan 19 September 2026; belum termasuk pajak dan diskon, dan AWS mengubahnya dari waktu ke waktu. Pengukuran berasal dari monitoring kami sendiri pada saat setiap perubahan dan menggambarkan momen itu, bukan kondisi permanen. Kami juga tidak menyertakan tagihan AWS, jenis dan jumlah mesin, tata letak jaringan, detail akun, nomor versi, maupun pengaturan keamanan kami: keputusannya berguna bagi pembaca, sedangkan konfigurasinya hanya berguna bagi orang yang ingin mengorek-ngoreknya. Ini menjelaskan infrastruktur kami sendiri dan bukan saran untuk infrastruktur Anda. Tidak ada data klien, mitra, atau pengiklan yang muncul di sini.