Backoff retry kami punya jitter. Jitter itu sudah dikonfigurasi, sudah diaktifkan, dan berjalan di setiap pesan yang kami publikasikan serta setiap pembacaan cache di bidder. Namun jitter itu juga menghasilkan angka yang persis sama, setiap kali dipanggil. Tes yang kami tulis untuknya lolos.
Inilah yang kami temukan, cara kami memperbaikinya, dan hal yang benar-benar kami ubah setelahnya — yang ternyata bukan kodenya.
Pertama, apa gunanya jitter
Ketika layanan yang Anda andalkan berhenti menjawab, Anda mencoba lagi (retry). Jika Anda langsung mencoba lagi tanpa henti, keadaan justru memburuk, jadi Anda menunggu sedikit lebih lama setelah setiap percobaan. Itulah backoff.
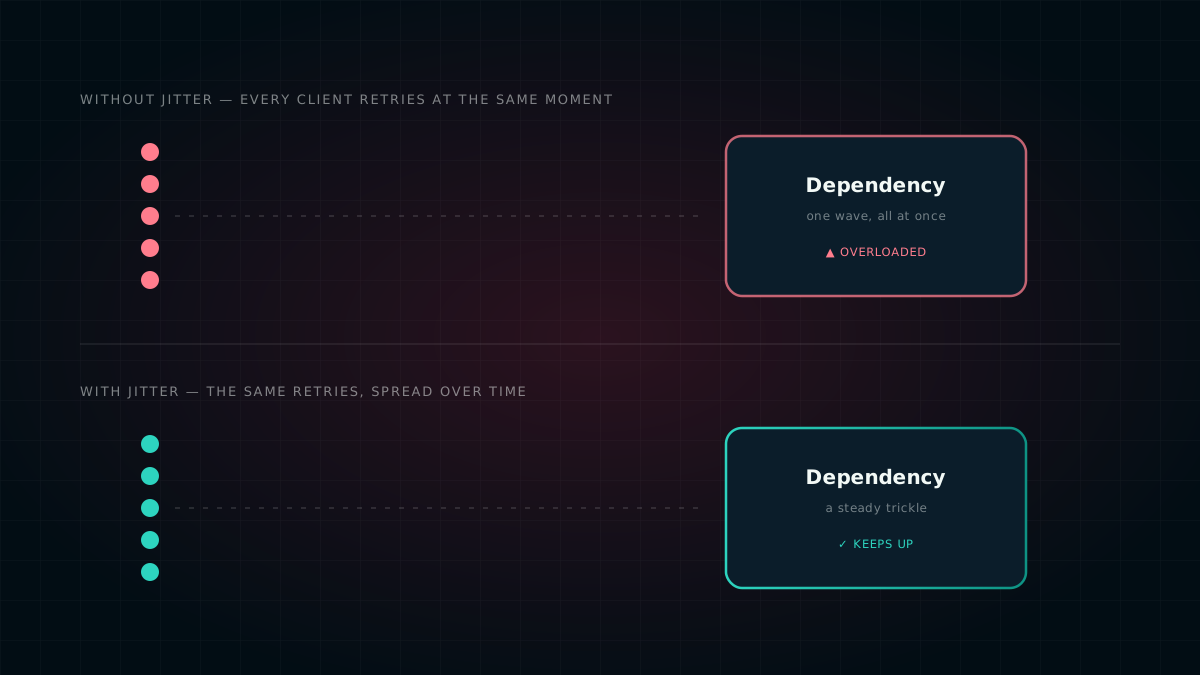
Namun backoff saja punya jebakan. Jika seratus mesin gagal pada saat yang sama dan semuanya menunggu dua detik yang sama, semuanya juga akan kembali pada saat yang sama. Dependensi dihantam satu dinding trafik, tumbang lagi, dan dinding itu terbentuk kembali. Itulah thundering herd, dan itulah pola yang terlihat di banner di atas.
Jitter adalah solusinya: beri setiap pihak yang menunggu waktu tunggu yang sedikit berbeda. Jumlah retry sama, tetapi tersebar dari waktu ke waktu. Cara ini hanya berhasil jika waktu tunggunya benar-benar berbeda satu sama lain.
Satu baris, dua bug
Jika disederhanakan ke intinya, kode kami terlihat seperti ini:
// Add jitter (±25%)
jitter := delay * 0.25 * (2*float64(time.Now().UnixNano()%2) - 1)
delay += jitter
Maksudnya bisa langsung terbaca, dan justru itulah sebabnya kode ini lolos review. Kode ini terlihat seperti cara biasa untuk menaikkan atau menurunkan jeda sebesar seperempat. Namun kode ini salah dalam dua hal yang terpisah, dan yang kedua adalah yang paling menarik.
Jam bukanlah koin
UnixNano() % 2 mengambil bit terakhir dari waktu saat ini dan memperlakukannya seperti lemparan koin. Padahal bukan. Apakah bit itu pernah berubah bergantung pada seberapa halus jam mesin Anda benar-benar berdetak — bukan pada peluang. Di mesin tempat kami mengukurnya, jam bergerak dalam langkah yang lebih kasar dari satu nanodetik, sehingga bit terakhir itu macet di nol dan tidak pernah berubah.
Artinya, pengalinya selalu -1. Dalam 100.000 panggilan dengan jeda dasar 100 ms, fungsi tersebut menghasilkan 75 ms sebanyak seratus ribu kali. Satu nilai. Potongan permanen 25%, yang menyamar sebagai keacakan. Variabel bernama jitter ternyata sebuah konstanta.
Dua nilai bukanlah sebaran
Sekarang anggap jamnya mau bekerja sama dan bit itu benar-benar berganti. Lihat apa yang bisa dihasilkan rumusnya: 2*bit - 1 menghasilkan -1 atau +1, tidak ada yang lain. Jadi jedanya hanya bisa 0.75× atau 1.25× dari nilai dasar — dua kemungkinan waktu tunggu.
Lemparan koin di antara dua waktu yang tetap tidak menyebarkan apa pun. Dua klien tetap bertabrakan separuh waktu, dan sekumpulan klien mendarat dalam dua gelombang alih-alih satu. Inilah bug yang tetap bertahan setelah bug pertama diperbaiki: ganti dengan angka acak yang benar, dan grafiknya akan terlihat lebih sehat, lolos jika hanya dilihat sekilas, sementara masalah sebenarnya tetap ada.
Berikut fungsi yang sama sebelum dan sesudah perbaikan, diukur dengan cara yang sama:
Kami menemukan ini dengan membaca kode kami sendiri, bukan karena melihat sesuatu rusak. Kami tidak punya bukti bahwa bug ini menyebabkan insiden. Ini juga bukan masalah keamanan — nilainya adalah jeda retry, bukan kata sandi atau kunci. Yang hilang adalah margin keamanan yang kami kira kami miliki. Perbedaan itu penting, dan layak disampaikan secara tepat di depan publik.
Tesnya adalah cerita yang sebenarnya
Bug yang menghasilkan satu nilai konstan di setiap panggilan seharusnya mudah ditangkap. Kami punya tes untuk fungsi yang persis ini. Inilah tesnya:
delays := make(map[time.Duration]bool)
for i := 0; i < 10; i++ {
    delays[calculateDelay(cfg, 0)] = true
}

// Should have some variation (may not always be true due to randomness)
// Just check it doesn't panic and returns reasonable values
for delay := range delays {
    if delay < 0 {
        t.Errorf("delay should not be negative, got %v", delay)
    }
}
Perhatikan apa yang dilakukannya. Tes ini mengumpulkan sepuluh jeda ke dalam sebuah set — struktur yang persis bisa mengungkap bug tersebut — lalu tidak pernah memeriksa seberapa besar set itu. Tes ini hanya memeriksa bahwa angkanya tidak negatif. Kami menjalankannya terhadap kode yang rusak untuk memastikan. Tes itu lolos dengan mudah.
Komentarnya adalah pengakuannya. “may not always be true due to randomness” (mungkin tidak selalu benar karena keacakan) adalah tanda seseorang menyadari bahwa pemeriksaan yang jelas akan flaky, lalu menyelesaikannya dengan menghapus pemeriksaan itu alih-alih membuatnya andal. Kompromi seperti itu sering dibuat, biasanya di bawah tekanan tenggat waktu, dan hampir selalu keliru.
Toleransi yang dilonggarkan untuk menghentikan tes yang flaky adalah toleransi yang kelak akan menyembunyikan bug sungguhan. Flake dan bug punya bentuk yang sama — keduanya berarti “nilainya tidak seperti yang saya harapkan” — sehingga rentang yang cukup lebar untuk meloloskan yang satu juga akan meloloskan yang lain. Ketika tes pada sesuatu yang acak terus salah memicu, perbaiki statistiknya, bukan ambang batasnya.
Memilih perbaikan adalah keputusan arsitektur
Ada serangkaian pilihan standar di sini, yang paling dikenal dari tulisan Marc Brooker tentang backoff di AWS. Full jitter memilih waktu tunggu di mana saja antara nol dan nilai jeda. Equal jitter mempertahankan separuh jeda sebagai batas bawah dan mengacak separuh lainnya. Decorrelated jitter menghitung setiap waktu tunggu dari waktu tunggu sebelumnya. Ketiganya tidak bisa saling menggantikan, dan pilihan yang tepat bergantung pada apa yang berada di bawah retry tersebut.
Full jitter menyebar paling lebar, dan itulah yang Anda inginkan. Konsekuensinya, sebuah retry bisa dipicu hampir seketika, sehingga backoff tidak lagi menjamin jarak minimum. Apakah Anda sanggup menerimanya sebenarnya bukan pertanyaan tentang jitter — melainkan pertanyaan tentang apa lagi yang melindungi dependensi tersebut.
Kami memilih full jitter karena setiap tempat yang memanggilnya sudah memiliki perlindungan itu: jalur database dan cache berada di balik circuit breaker, dan jalur message broker memiliki batas waktu tulis per percobaan di dalam anggaran waktu keseluruhan yang terbatas. Sudah ada komponen lain yang bertanggung jawab untuk menolak menghantam layanan yang mati. Tanpa itu, batas bawah dari equal jitter akan menjadi kompromi yang lebih tepat.
delay = rand.Float64() * delay // full jitter: anywhere in [0, delay)Penggantinya mengecilkan jeda alih-alih menggesernya, yang diam-diam memperbaiki hal ketiga. ±25% yang lama bisa mendorong waktu tunggu seperempat melewati batas atas yang telah kami konfigurasi. Mengalikan dengan angka di bawah 1 membuat nilai maksimum benar-benar menjadi maksimum. Cara ini juga tidak bisa menghasilkan angka negatif, sehingga kami bisa menghapus cabang defensif if delay < 0 yang selama ini menutupi gejalanya.
Membuktikan bahwa perbaikan yang acak benar-benar berhasil
Menguji keacakan punya mode kegagalan tersendiri: sangat mudah menulis tes yang meloloskan segalanya, dan begitulah awal mula kami sampai di sini. Jadi tes yang baru memeriksa tiga hal — setiap nilai berada di dalam [0, base), setidaknya separuh dari 1.000 pengambilan berbeda satu sama lain, dan rata-ratanya berada dalam 5% dari nilai seharusnya.
Lalu kami memeriksa bahwa pemeriksaan tersebut benar-benar bisa gagal, dengan menjalankannya terhadap empat versi yang sengaja dirusak:
| Versi rusak | Apa yang diwakilinya | Hasil |
|---|---|---|
| Baris clock-bit yang asli | Bug seperti saat dirilis | tertangkap |
| Angka acak yang benar, masih ±25% dua arah | Kode yang sama di mesin yang bit jamnya memang berganti | tertangkap |
| Acak tetapi sempit, 0,99–1,00× | Keacakan sungguhan, tanpa sebaran yang berguna | tertangkap |
| Jitter diam-diam dihapus | Perubahan di masa depan menghilangkan panggilannya | tertangkap |
Baris yang disorot adalah yang paling berharga. Baris itu punya angka acak yang sepenuhnya baik dan tetap gagal — artinya tes ini memeriksa bentuk sebarannya, bukan kesehatan generator angka acaknya. Itulah yang membuat hasilnya portabel: kami tidak bisa mereproduksi perilaku jam tersebut di mesin build kami, dan berkat versi rusak tiruan itu kami tidak perlu melakukannya.
Tentang flakiness, hal yang memulai semua ini: pemeriksaan rata-rata berada sekitar lima setengah standar deviasi dari batasnya pada seribu sampel. Itu cukup ketat untuk menangkap sebaran yang kolaps dan cukup longgar sehingga praktis tidak akan pernah terpicu secara kebetulan. Kami menjalankannya 500 kali untuk memastikan. Tes pada hal yang acak tidak harus flaky. Tes itu harus diukur dengan tepat.
Di mana bug seperti ini bersembunyi dalam platform iklan
Real-time bidding adalah tempat yang sangat cocok bagi bug semacam ini. Banyak pod stateless yang identik, beberapa dependensi bersama, batas waktu lelang yang ketat dalam hitungan milidetik, dan trafik yang benar-benar datang serempak di awal setiap jam. Keacakan yang disengaja berperan nyata di lebih banyak tempat dibanding kebanyakan sistem — dan di setiap tempat itu, sebaran yang kolaps gagal tanpa suara. Kodenya berjalan. Angkanya terlihat masuk akal. Tesnya tetap hijau.
Kasus di atas. Backoff yang tersinkronisasi mengubah gangguan singkat menjadi gelombang berulang yang datang tepat ketika dependensi sedang berusaha pulih.
Menyebarkan belanja kampanye sepanjang hari bergantung pada pengambilan acak. Jika keacakan itu kolaps, seluruh jatah dibelanjakan di menit-menit pertama — yang terlihat seperti lonjakan trafik padahal sebenarnya bug sampling.
Entri yang ditulis bersamaan dengan masa berlaku yang sama akan kedaluwarsa bersamaan. Tanpa kedaluwarsa yang diberi jitter, cache yang hangat kosong sekaligus dan semuanya berbondong-bondong ke sumber.
Beberapa optimizer terus belajar dengan mencoba opsi secara acak. Jika sampler-nya kolaps, eksplorasi diam-diam berhenti dan model dengan yakin menetap pada apa pun yang kebetulan dicobanya pertama kali.
Menempatkan pengguna ke dalam grup tes atau bucket frekuensi membutuhkan pembagian yang merata. Ketimpangan di sini tidak membuat apa pun crash — tetapi diam-diam membengkokkan setiap angka yang Anda laporkan setelahnya.
Sampler yang bias salah merepresentasikan justru kasus-kasus langka yang ingin Anda pantau, dan melakukannya cukup konsisten sehingga terlihat seperti pengukuran sungguhan.
Aturan yang mendasari semuanya cukup singkat untuk diingat: di mana pun keacakan digunakan untuk menyebarkan sesuatu, sebaran yang kolaps mengubahnya menjadi penyinkron. Mekanismenya tidak melemah. Mekanismenya terbalik.
Yang kami pelajari
- Perlakukan keacakan sebagai infrastruktur. Sumber keacakan layak mendapat perhatian yang sama seperti jam atau generator ID. Membuatnya dari timestamp adalah tanda bahaya yang perlu dikenali — timestamp hanya bergerak naik, dan bergerak dalam langkah-langkah, dua sifat yang paling tidak Anda inginkan.
- Periksa sebarannya, bukan sekadar tidak adanya crash. “Menghasilkan nilai yang masuk akal” bisa dipenuhi oleh sebuah konstanta. Menghitung nilai unik, memeriksa batas, dan rata-rata dengan ukuran sampel yang tepat itu murah dan benar-benar memberi tahu Anda sesuatu.
- Rusak tes Anda sendiri dengan sengaja. Jika Anda tidak bisa menunjukkan tes baru Anda gagal terhadap versi salah yang masuk akal, Anda belum menunjukkan bahwa tes itu benar-benar menguji sesuatu.
- Jangan pernah melebarkan toleransi untuk memperbaiki tes yang flaky. Buat tes itu deterministik, atau ukur statistiknya dengan benar. Batas yang dilonggarkan adalah bug yang sengaja diterima — dan komentar yang menjelaskan alasannya akan tetap ada saat hal itu menjadi penting.
- Pilih skema jitter berdasarkan apa yang ada di bawahnya. Full jitter adalah default yang tepat jika circuit breaker atau timeout sudah membatasi kerusakannya. Tanpa itu, pilihlah batas bawah.
Jika Anda ingin gambaran yang lebih luas tentang bagaimana bidder ini disusun, ada di artikel arsitektur kami. Dan jika ini jenis pekerjaan engineering yang Anda sukai, sesekali kami membuka posisi di Dhaka.
Setiap pengukuran di sini dilakukan terhadap implementasi sebenarnya, sebelum dan sesudah perubahan: 100.000 panggilan, jeda dasar 100 ms, bucket 10 ms. Tiga skema jitter mengikuti pembagian standar full / equal / decorrelated dari tulisan Marc Brooker tentang backoff dan jitter di AWS, yang dirujuk di sini sebatas isi yang disampaikannya secara publik. Kode yang ditampilkan adalah milik kami sendiri, dipangkas hingga baris-baris yang penting — kami tidak memublikasikan konfigurasi, endpoint, atau apa pun tentang pengaturan keamanan kami.